


Den korte version
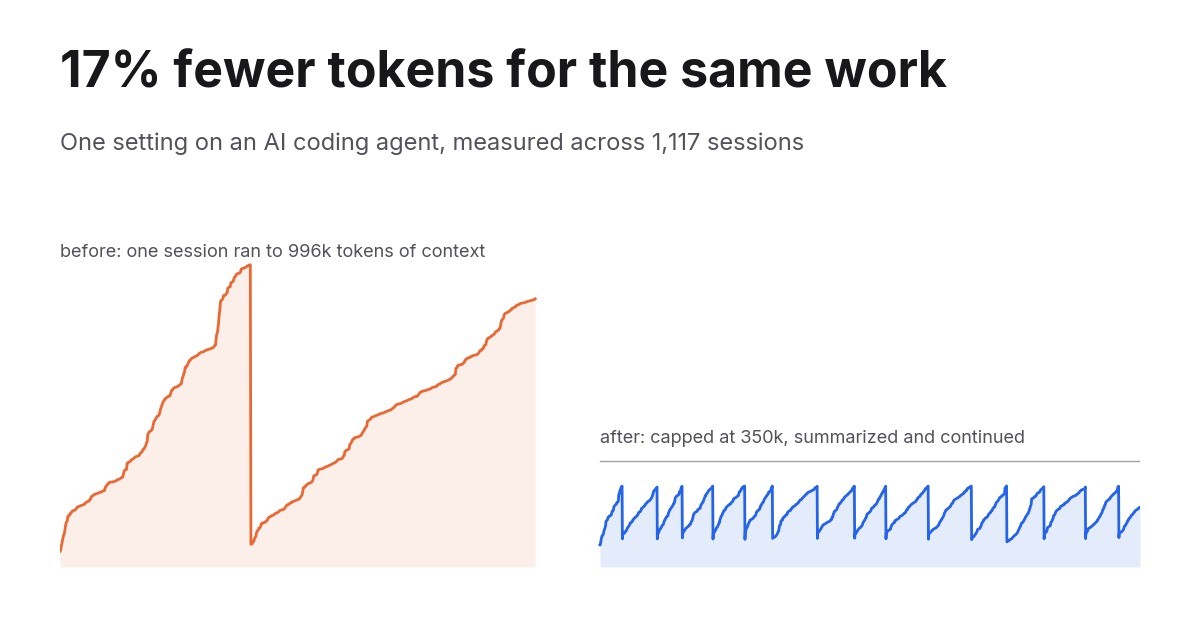
- Jeg kører en AI-kodeagent hele dagen på en model med et kontekstvindue på 1M tokens. Sessioner plejede at vokse, indtil de næsten fyldte det.
- Jeg tilføjede én linje til dens config, som begrænser en session til 350.000 tokens kontekst, før den opsummerer sig selv og fortsætter.
- Målt på tværs af 1.117 sessionstranskriptioner: 17% færre tokens for det samme antal prompts, og i de lange sessioner, hvor loftet faktisk bider, 55% færre.
Nedenfor er metoden, hvert eneste diagram og hvad det koster dig til gengæld, så du kan vurdere, om det gælder for dit setup.
Hvorfor et vindue på 1M koster mere, end det ser ud til
En samtale med en model er stateless. Hver request bærer hele historikken: systemprompten, hver værktøjsdefinition, hver fil agenten har læst, hvert værktøjsresultat, hver besked. Ikke et delta. Det hele, hver gang.
Så en session, der er vokset til 900.000 tokens, betaler for 900.000 tokens input ved næste kald og ved kaldet efter det. Tur 400 udfører ikke mere arbejde end tur 4. Den koster bare mange gange mere.
Prompt-caching bløder det op. Tokens, som modellen har set før, faktureres til omkring en tiendedel af den normale inputpris. Rabatten er reel, den er det, der overhovedet gør lange sessioner levedygtige, og den er også grunden til, at ingen ser på problemet. I mine data var 98% af alle input-tokens cache-læsninger. En tiendedel af et meget stort tal var stadig den største post på regningen.
Spørgsmålet er ikke, om din historik er cachet. Det er, hvor stor den får lov at blive, før noget nulstiller den.

Klar til at vokse din virksomhed?
Start din gratis prøveperiode i dag og se resultater inden for få dage.
Hvad jeg ændrede
Agenten er Claude Code, der kører Opus på 1M-kontekstvinduet. Indstillingen er autoCompactWindow i ~/.claude/settings.json. Når en session når op på så mange tokens, opsummerer agenten samtalen og fortsætter ud fra opsummeringen.
{
  "autoCompactWindow": 350000
}
Jeg havde aldrig sat den, så sessioner kørte, indtil de nærmede sig det fulde vindue. Over fire dage prøvede jeg tre værdier:
| Dato | Indstilling |
|---|---|
| 14. september | 250.000 |
| 15. september | 300.000 |
| 18. september | 350.000 |
Sådan målte jeg det
Claude Code skriver hver session til en JSONL-transskription under ~/.claude/projects/, inklusive tokenforbruget for hvert API-kald. Jeg parsete alle 1.117 af dem, dækkende fem uger fra 19. august til 22. september, dedupliceret efter request-ID, og beholdt kun interaktive sessioner. Kørsler i GitHub Actions bruger samme konto, men kan ikke påvirkes af en indstilling på min laptop, så de er udeladt.
Rå token-totaler er misvisende i sig selv. En travl uge slår en stille uge, uanset hvad du ændrer. Derfor er hvert tal nedenfor cache-vægtet, hvilket er det, måleren faktisk aflæser: frisk input til 1x, cache-skrivninger til 1,25x (5-minutters cache) eller 2x (1-times cache), cache-læsninger til 0,1x. Og hver sammenligning er normaliseret efter udført arbejde, enten de prompts jeg skrev, eller de API-kald agenten lavede.
Tilmeld dig vores nyhedsbrev
Få de seneste tips, trends og tilbud gratis.
To sessioner, samme agent
Dette er mekanismen i ét billede. Til venstre en rigtig session fra 3. september, før loftet. Til højre en rigtig session fra 15. september, efter.
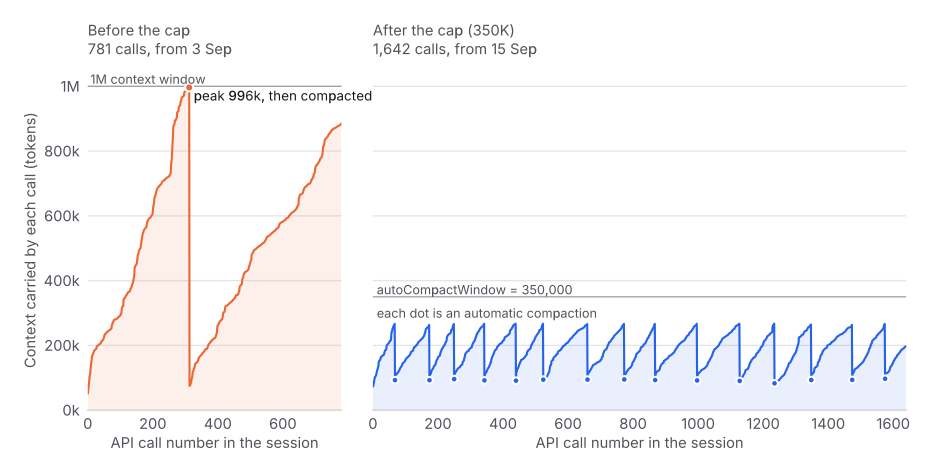
Sessionen til venstre kørte i 781 kald. Den klatrede til 996.000 tokens kontekst, ramte væggen i 1M-vinduet, komprimerede én gang og klatrede derefter lige tilbage til 880.000. I den anden halvdel af den session genlæste hvert eneste kald mere end en halv million tokens.
Sessionen til højre kørte i 1.642 kald, mere end dobbelt så længe, og bar aldrig mere end 270.000. Den komprimerede femten gange. Hver komprimering er en prik.
De ugentlige tal
Kun interaktive sessioner. Søjlerne er cache-vægtede input-tokens pr. API-kald, hvilket er det faireste enkelttal, fordi det ikke afhænger af, hvor meget jeg arbejdede i en given uge.
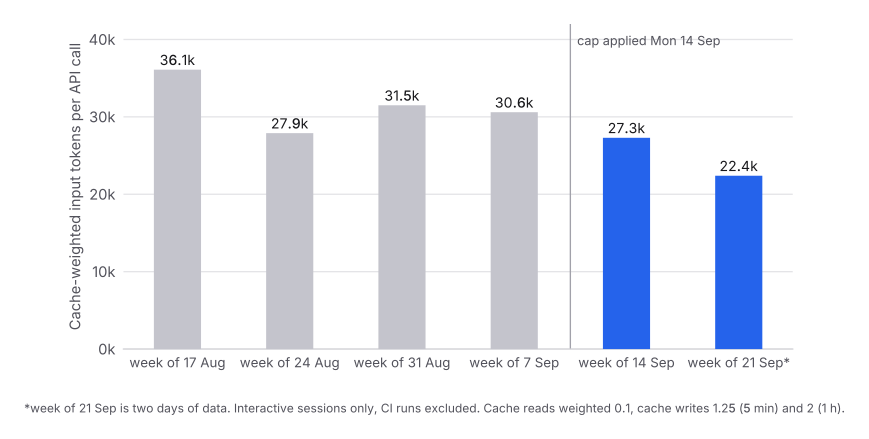
Den reneste sammenligning i datasættet er ugen fra 7. september mod ugen fra 14. september, fordi jeg ikke valgte dem. De landede bare på hver sin side af ændringen, og jeg skrev næsten præcis det samme antal prompts i hver.
| Uge fra | Prompts | API-kald | Cache-vægtet input | Pr. kald |
|---|---|---|---|---|
| 7. sep | 971 | 11.364 | 348,1M | 30,6k |
| 14. sep | 968 | 10.555 | 288,5M | 27,3k |
971 prompts mod 968. Effektiv input ned fra 348,1M til 288,5M. Det er 17% mindre for den samme mængde prompting. De to dage i den følgende uge landede på 22,4k pr. kald, endnu lavere.
Hvor pengene gik hen
Opdel hvert API-kald efter, hvor meget kontekst det bar, og mekanismen bliver direkte synlig.
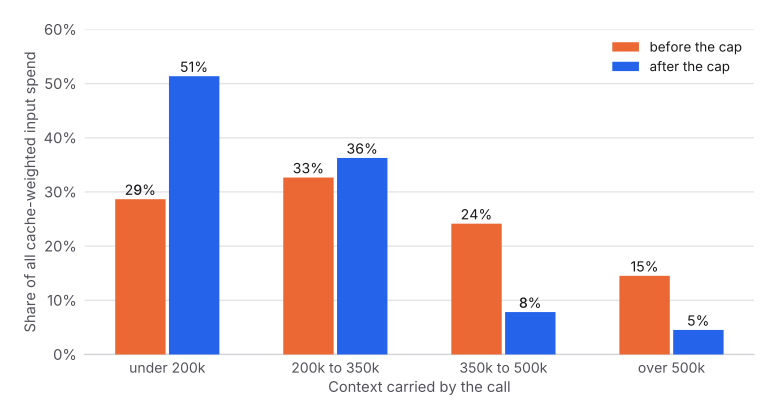
Før loftet gik 39% af alt, hvad jeg brugte, til kald, der slæbte mere end 350.000 tokens historik med sig. De kald udførte ikke mere arbejde end de andre. Det var det samme arbejde med mere bagage. Efter loftet er den andel 12%.
Holdt loftet?
Én prik pr. session, placeret ved den største kontekst, den pågældende session nogensinde bar.
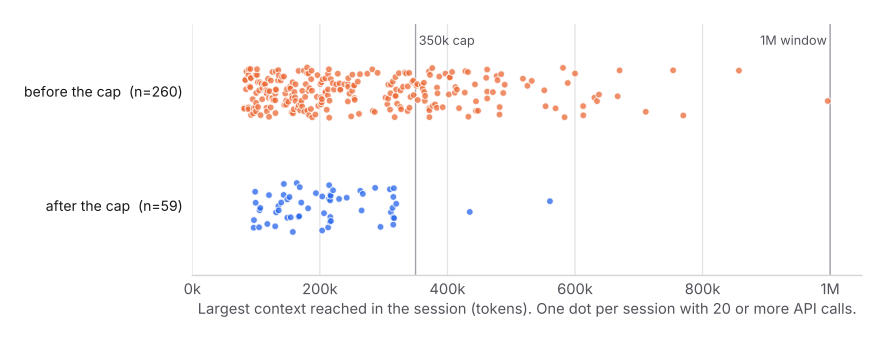
To sessioner i de første to dage kørte stadig forbi loftet, til 434.000 og 561.000, og jeg fandt aldrig ud af hvorfor. Siden indstillingen på 350.000 blev sat ind den 18. september, har ingen session overskredet den. Halen af sessioner, der levede mellem 500k og 1M, hvor det meste af spildet var, er væk.
Hvad det ville have kostet uden loftet
For at sætte et samlet tal på det afspillede jeg hver session, der startede efter ændringen, som om den droppede kontekst aldrig var blevet opsummeret og stadig blev genlæst ved hvert senere kald, begrænset til 1M-vinduet.
| Cache-vægtet input | |
|---|---|
| Faktisk, 73 sessioner, 9.675 kald, 55 komprimeringer | 216,8M |
| Samme sessioner uden loftet | 479,2M |
| Undgået | 262,5M, eller 55% |
Sessionen til højre i det første diagram står alene for 118,5M af det. En lang refaktorering, der ellers ville have brugt sine sidste flere hundrede kald på at genlæse næsten en million tokens hver.
Betragt 55% som den optimistiske ende. Uden loftet ville jeg næppe reelt have ladet en session male på 900k i timevis; til sidst ville jeg have ryddet den manuelt, hvilket også nulstiller omkostningen. Den konservative ende er det observerede tal pr. kald, 30,6k ned til 22,4k, altså cirka 20% til 27%. Sandheden ligger et sted mellem de to.
Hvad det koster dig
Det er ikke gratis, og enhver, der anbefaler det, bør sige det.
Ventetid. 67 komprimeringer siden ændringen, med en median på cirka tre minutter hver. Rundt regnet 3,4 timer med at se en opsummering blive skrevet, fordelt over otte dage.
Noget omarbejde. Komprimering dropper en hel del. Ved indstillingen på 350K tog den mediane komprimering en session på 318.000 tokens ned til 24.000. Agenten mister detaljer og genopbygger dem nogle gange: filer genlæst inden for samme session gik fra 11,5% af læsningerne før den første komprimering til 20,5% efter. Stikprøven bag det andet tal er lille, så læs det som en retning snarere end en måling.
Valget af tærskel betyder noget. Ved 250K ramte 36% af mine lange sessioner en komprimering. Ved 350K gjaldt det 12%, mens loftet stadig holdt. Sætter du den for lavt, betaler du de tre minutter og omarbejdet igen og igen for en besparelse, du allerede havde i hus.
Sådan sætter du det op
Claude Code. Tilføj autoCompactWindow til ~/.claude/settings.json. På en model med 1M-kontekst var 350.000 den bedste af de tre værdier, jeg prøvede. På en 200K-model skal du skalere ned og starte omkring 120.000 til 140.000. Nye sessioner tager den til sig; en session, der allerede kører, beholder den gamle værdi.
Andre agenter. Led efter den samme idé under et andet navn: en komprimeringsudløser, en kontekstgrænse, en opsummer-og-fortsæt-tærskel. Findes der ingen, er den manuelle version at rydde sessionen oftere, end det føles naturligt. Instinktet om at holde én lang session i live hele dagen, fordi den “kender projektet”, er det dyre.
Uanset hvad du bruger, gør to vaner mere end nogen indstilling. Hold varig state i filer frem for i samtalen, så agenten billigt kan genlæse én fil i stedet for at bære hvert tidligere svar for evigt. Og skub læsetungt arbejde ud til subagenter med deres egen kortlivede kontekst, så de tyve filer, de læser, slet ikke kommer ind i hovedsessionen.
Hvis du er på en ugentlig grænse
Hvis du betaler et abonnement med en ugentlig brugsgrænse i stedet for en regning pr. token, er dette den løftestang med det bedste forhold mellem indsats og effekt, jeg har fundet. Én linje JSON, ingen ændring af måden, du arbejder på, og den samme grænse rækker målbart længere. I mit tilfælde kostede det samme ugentlige promptvolumen 17% mindre, og de lange sessioner kostede omkring det halve.
Læs næste
Kontekstvinduer sælges som kapacitet. De opfører sig som en løbende måler, der ved hver tur opkræver for alt, hvad du nogensinde har lagt ind. Hvis du vil have mekanikken bag dette frem for bare indstillingen, gennemgår den tilhørende artikel , hvad der faktisk fylder et kontekstvindue, hvorfor en lang session koster langt mere end det arbejde, den udfører, og hvordan caching, rydning og komprimering hver især ændrer regnestykket.
