


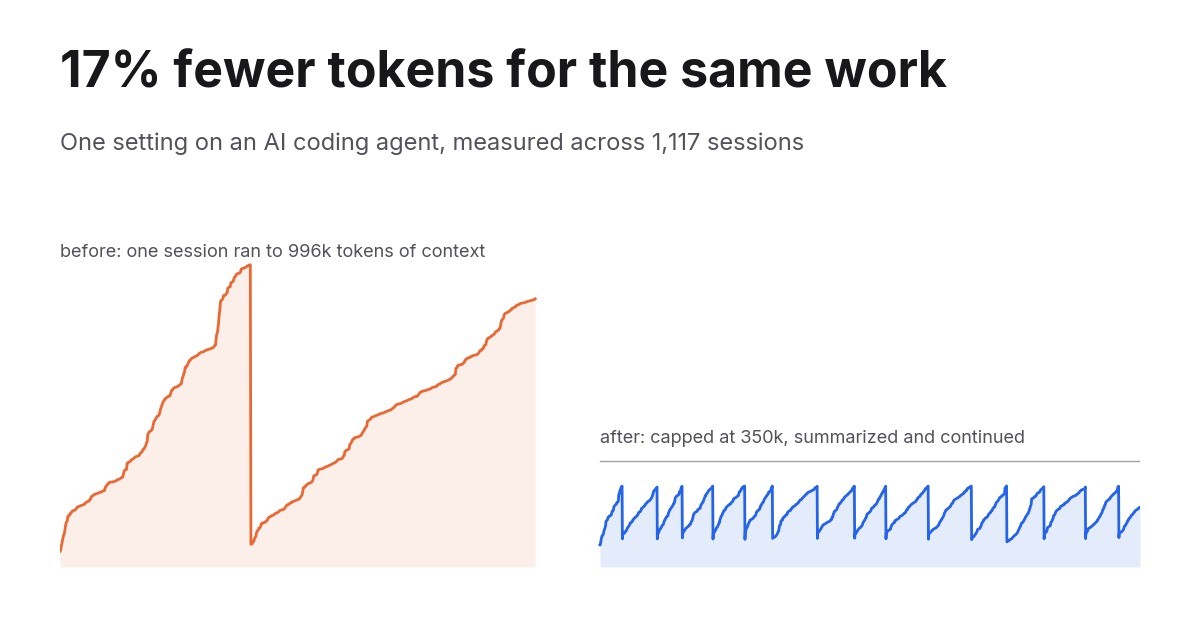
要点
- 私は1Mトークンのコンテキストウィンドウを持つモデルで、一日中AIコーディングエージェントを動かしています。以前はセッションがそれをほぼ埋め尽くすまで成長していました。
- 設定に1行追加し、セッションのコンテキストを350,000トークンで上限を設けて、そこで自己要約して続行するようにしました。
- 1,117件のセッション記録を測定した結果:同じプロンプト数でトークンは17%減、上限が実際に効いている長いセッションでは55%減でした。
以下に手法、すべてのグラフ、そしてその代償をまとめます。自分の環境に当てはまるかどうかを判断する材料にしてください。
なぜ1Mウィンドウは見た目より高くつくのか
モデルとの会話はステートレスです。すべてのリクエストが履歴全体を運びます。システムプロンプト、すべてのツール定義、エージェントが読んだすべてのファイル、すべてのツール結果、すべてのメッセージ。差分ではありません。毎回、全部です。
そのため、900,000トークンまで成長したセッションは、次の呼び出しでもその次の呼び出しでも、入力900,000トークン分を支払います。400ターン目は4ターン目より多くの仕事をしているわけではありません。ただ何倍も高くつくだけです。
プロンプトキャッシュはこれを和らげます。モデルが以前に見たトークンは、通常の入力価格のおよそ10分の1で請求されます。この割引は実際に存在し、長いセッションをそもそも成立させているものであり、同時に誰もこの問題を見ようとしない理由でもあります。私のデータでは、入力トークン全体の98%がキャッシュ読み取りでした。非常に大きな数の10分の1は、それでも請求額の中で最大の項目でした。
問題は、履歴がキャッシュされているかどうかではありません。何かがリセットするまでに、どこまで大きくしてよいかです。
私が変更したこと
エージェントは1MコンテキストウィンドウでOpusを動かすClaude Codeです。設定は ~/.claude/settings.json の autoCompactWindow です。セッションがそのトークン数に達すると、エージェントは会話を要約し、その要約から続行します。
{
  "autoCompactWindow": 350000
}
これまで一度も設定していなかったので、セッションはウィンドウ上限に近づくまで走っていました。4日間にわたって3つの値を試しました。
| 日付 | 設定値 |
|---|---|
| 9月14日 | 250,000 |
| 9月15日 | 300,000 |
| 9月18日 | 350,000 |
測定方法
Claude Codeはすべてのセッションを ~/.claude/projects/ 配下のJSONL記録として書き出し、各API呼び出しのトークン使用量も含まれます。私はその1,117件すべてを解析しました。対象は8月19日から9月22日までの5週間で、リクエストIDで重複を排除し、対話型セッションのみを残しました。GitHub Actionsでの実行は同じアカウントを使いますが、私のノートPC上の設定の影響を受けようがないため、除外しています。
生のトークン合計だけでは誤解を招きます。忙しい週は、何を変えても静かな週に勝ちます。そこで以下の数字はすべてキャッシュ加重です。これはメーターが実際に読む値です:新規入力は1倍、キャッシュ書き込みは1.25倍(5分キャッシュ)または2倍(1時間キャッシュ)、キャッシュ読み取りは0.1倍。そしてすべての比較は、行った作業量(私が入力したプロンプト数、またはエージェントが行ったAPI呼び出し数)で正規化しています。

ニュースレターに登録
最新のヒント、トレンド、お得な情報を無料で入手。
2つのセッション、同じエージェント
これが1枚の図でわかる仕組みです。左は上限設定前の、9月3日の実際のセッション。右は設定後の、9月15日の実際のセッションです。
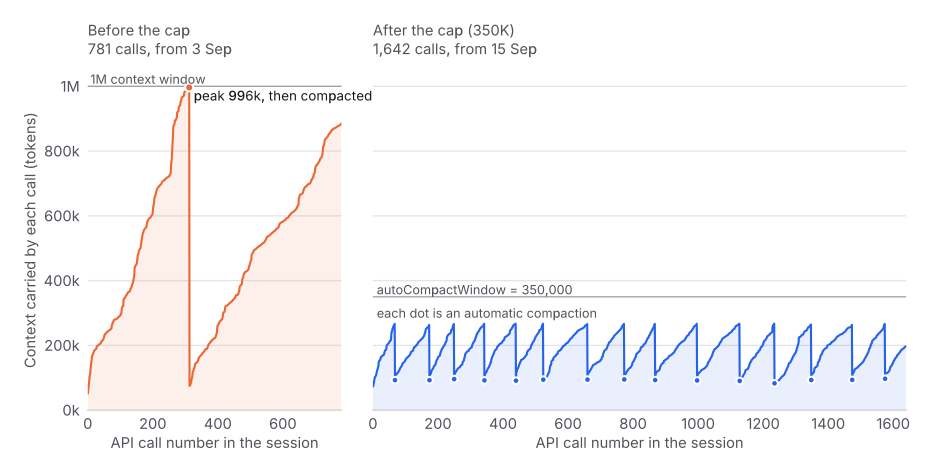
左のセッションは781回の呼び出しにわたりました。コンテキストは996,000トークンまで上昇し、1Mウィンドウの壁にぶつかり、1回圧縮され、そのまま880,000まで戻りました。そのセッションの後半では、呼び出しのたびに50万トークン以上を読み直していました。
右のセッションは1,642回の呼び出しにわたり、2倍以上の長さでしたが、270,000を超えることはありませんでした。15回圧縮されています。各圧縮が1つの点です。
週次の数字
対話型セッションのみ。棒はAPI呼び出しあたりのキャッシュ加重入力トークンで、特定の週にどれだけ作業したかに左右されないため、最も公平な単一指標です。
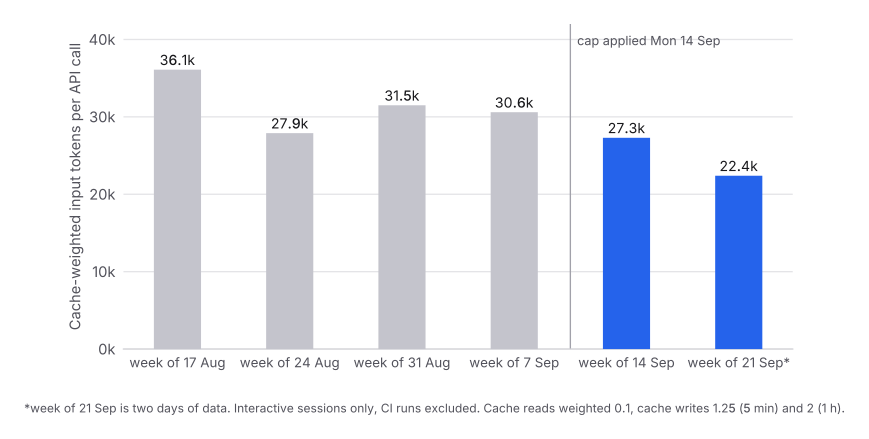
データセットで最もクリーンな比較は、9月7日の週と9月14日の週です。これは私が選んだわけではないからです。変更を挟んで両側にたまたま位置し、入力したプロンプト数もほぼ同じでした。
| 週 | プロンプト数 | API呼び出し数 | キャッシュ加重入力 | 呼び出しあたり |
|---|---|---|---|---|
| 9月7日 | 971 | 11,364 | 348.1M | 30.6k |
| 9月14日 | 968 | 10,555 | 288.5M | 27.3k |
971プロンプト対968プロンプト。実効入力は348.1Mから288.5Mへ減少。同じプロンプト量で17%減です。翌週の2日間は呼び出しあたり22.4kで、さらに低くなりました。
お金はどこに消えていたのか
すべてのAPI呼び出しを、運んでいたコンテキストの大きさで分割すると、仕組みが直接見えてきます。
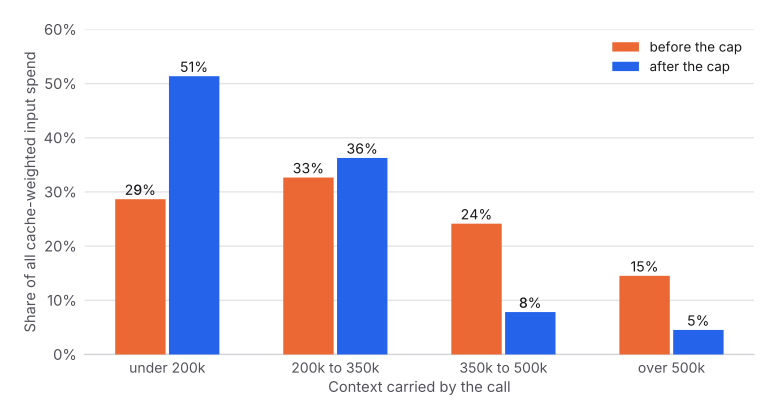
上限設定前は、私の支出全体の39%が、350,000トークン超の履歴を引きずる呼び出しに注ぎ込まれていました。 それらの呼び出しは他より多くの仕事をしていたわけではありません。同じ仕事を、より多くの荷物を抱えて行っていただけです。上限設定後、その割合は12%です。
天井は維持されたか
1セッションにつき1つの点で、そのセッションがこれまで運んだ最大のコンテキストの位置に置いています。
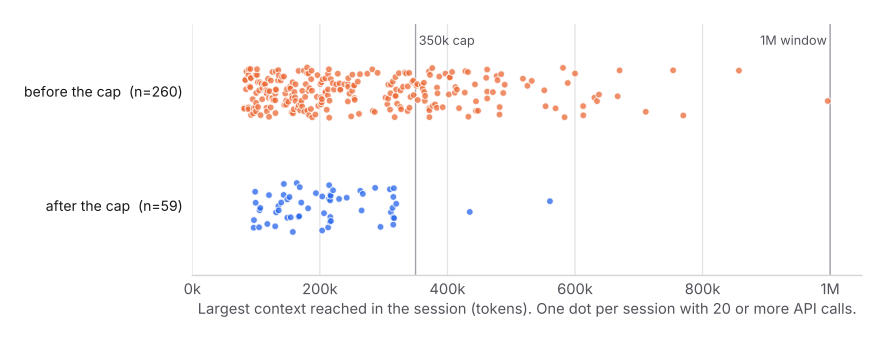
最初の2日間の2つのセッションは上限を超えて、434,000と561,000まで走り、その理由はわかりませんでした。9月18日に350,000の設定を入れて以降、それを超えたセッションはありません。500kから1Mの間にあったセッション群、つまり無駄の大半があった部分は消えました。
上限がなければいくらかかっていたか
総額を出すために、変更後に開始したすべてのセッションを、落とされたコンテキストが要約されずに、その後のすべての呼び出しで読み直され続けていたかのように、1Mウィンドウを上限として再実行しました。
| キャッシュ加重入力 | |
|---|---|
| 実測、73セッション、9,675呼び出し、55回の圧縮 | 216.8M |
| 同じセッションを上限なしで実行した場合 | 479.2M |
| 回避分 | 262.5M、つまり55% |
最初のグラフの右側のセッションだけで、そのうち118.5Mを占めます。長いリファクタリングで、そうでなければ最後の数百回の呼び出しを毎回100万トークン近く読み直すことに費やしていたものです。
55%は楽観的な端と考えてください。上限がなければ、私は実際にはセッションを何時間も900kで回し続けたりはしなかったでしょう。いずれ手動でクリアしていたはずで、それもコストをリセットします。保守的な端は観測された呼び出しあたりの数値、つまり30.6kから22.4kで、およそ20%から27%です。真実はその2つの間のどこかにあります。
その代償
これは無料ではありません。勧める人はそう言うべきです。
待ち時間。 変更後の圧縮は67回、中央値で1回あたり約3分。8日間にわたって、要約が書かれるのを見ている時間がおよそ3.4時間。
ある程度の手戻り。 圧縮は多くのものを落とします。350K設定では、圧縮の中央値は318,000トークンのセッションを24,000まで縮めました。エージェントは細部を失い、時にそれを再構築します。同じセッション内で再読されたファイルは、最初の圧縮前の読み取りの11.5%から、圧縮後は20.5%に増えました。2つ目の数値の根拠となるサンプルは小さいので、測定値ではなく方向性として読んでください。
しきい値の選び方が重要です。 250Kでは、長いセッションの36%で圧縮が発生しました。350Kでは12%で、しかも天井は維持されました。低く設定しすぎると、すでに得ていた節約のために、3分と手戻りを繰り返し支払うことになります。
設定方法
Claude Code。 ~/.claude/settings.json に autoCompactWindow を追加します。1Mコンテキストのモデルでは、試した3つの値の中で350,000が最良でした。200Kモデルではスケールダウンして、120,000から140,000あたりから始めてください。新しいセッションはこれを読み込みますが、すでに実行中のセッションは古い値のままです。
その他のエージェント。 同じ考え方を別の名前で探してください:圧縮トリガー、コンテキスト上限、要約して続行するしきい値。見つからなければ、手動版は自然に感じるより頻繁にセッションをクリアすることです。「プロジェクトを理解している」からと1つの長いセッションを一日中生かしておく直感こそが、高くつくものです。
何を使うにせよ、2つの習慣はどんな設定よりも効果があります。 永続的な状態は会話ではなくファイルに置き、エージェントが以前のすべての回答を永遠に抱えるのではなく、1つのファイルを安く読み直せるようにすること。そして、読むことの多い作業は独自の短命なコンテキストを持つサブエージェントに押し出し、彼らが読む20個のファイルがメインセッションに一切入らないようにすることです。
週次上限を使っている場合
トークン単位の請求ではなく、週次使用量上限付きのサブスクリプションを支払っているなら、これは私が見つけた中で労力対効果の比が最も良いレバーです。JSON1行、働き方を変える必要なし、そして同じ上限が測定できるほど長く持ちます。私の場合、同じ週次プロンプト量のコストが17%減り、長いセッションはおよそ半分になりました。
次に読む
コンテキストウィンドウは容量として売られています。しかし実際は走行メーターのように振る舞い、これまで入れたすべてに対して毎ターン課金されます。設定だけでなくその仕組みを知りたい場合は、関連記事 で、コンテキストウィンドウを実際に埋めているもの、長いセッションがなぜその作業量のはるかに上を行くコストになるのか、そしてキャッシュ、クリア、圧縮がそれぞれ計算をどう変えるのかを順に解説しています。
