


Krátká verze
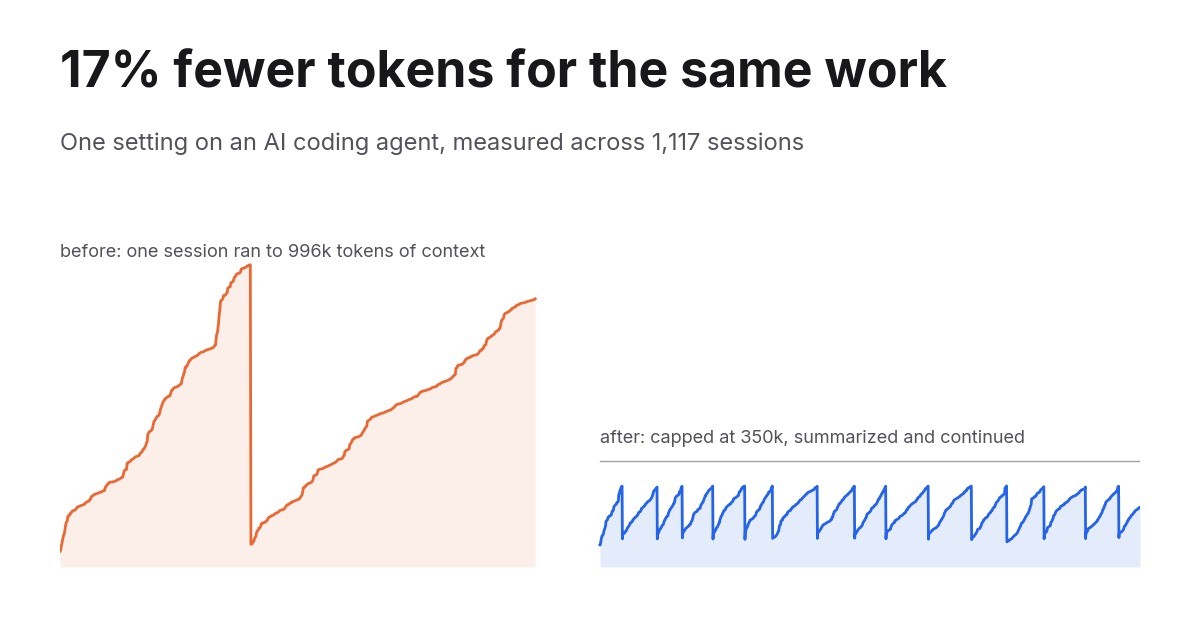
- Celý den používám AI kódovacího agenta na modelu s kontextovým oknem 1M tokenů. Relace dříve rostly, dokud ho téměř nenaplnily.
- Přidal jsem do jeho konfigurace jeden řádek, který omezuje relaci na 350 000 tokenů kontextu, než se sama shrne a pokračuje.
- Změřeno na 1 117 přepisech relací: o 17 % méně tokenů za stejný počet promptů a v dlouhých relacích, kde strop skutečně zabírá, o 55 % méně.
Níže je metoda, každý graf a co vás to bude stát na oplátku, abyste se mohli rozhodnout, jestli to platí pro vaše uspořádání.
Proč 1M okno stojí víc, než se zdá
Konverzace s modelem je bezstavová. Každý požadavek nese celou historii: systémový prompt, každou definici nástroje, každý soubor, který agent přečetl, každý výsledek nástroje, každou zprávu. Ne delta. Všechno to, pokaždé.
Takže relace, která narostla na 900 000 tokenů, platí 900 000 vstupních tokenů při dalším volání a i při tom následujícím. 400. tah neudělá víc práce než 4. tah. Jen stojí mnohonásobně víc.
Prompt caching to zmírňuje. Tokeny, které model už viděl, se účtují přibližně za desetinu běžné vstupní ceny. Ta sleva je skutečná, je to to, co vůbec dělá dlouhé relace životaschopnými, a také to je důvod, proč se na problém nikdo nedívá. V mých datech bylo 98 % všech vstupních tokenů čtení z cache. Desetina velmi velkého čísla byla stále největší položkou na účtu.
Otázka nezní, jestli je vaše historie cachovaná. Ale jak velká se smí stát, než ji něco resetuje.

Připraveni rozšířit své podnikání?
Začněte svou bezplatnou zkušební verzi ještě dnes a viďte výsledky během několika dní.
Co jsem změnil
Agentem je Claude Code běžící na Opus s 1M kontextovým oknem. Nastavení je autoCompactWindow v ~/.claude/settings.json. Když relace dosáhne tohoto počtu tokenů, agent shrne konverzaci a pokračuje ze shrnutí.
{
  "autoCompactWindow": 350000
}
Nikdy jsem ho nenastavil, takže relace běžely, dokud se nepřiblížily plnému oknu. Během čtyř dnů jsem vyzkoušel tři hodnoty:
| Datum | Nastavení |
|---|---|
| 14. září | 250 000 |
| 15. září | 300 000 |
| 18. září | 350 000 |
Jak jsem to měřil
Claude Code zapisuje každou relaci do JSONL přepisu pod ~/.claude/projects/, včetně spotřeby tokenů u každého volání API. Zpracoval jsem všech 1 117 z nich, pokrývajících pět týdnů od 19. srpna do 22. září, odstranil duplicity podle ID požadavku a ponechal jen interaktivní relace. Běhy v GitHub Actions používají stejný účet, ale nemůže je ovlivnit nastavení na mém notebooku, takže jsou vyloučeny.
Surové součty tokenů jsou samy o sobě zavádějící. Rušný týden porazí klidný týden, ať změníte cokoli. Proto je každé číslo níže vážené cache, což je to, co měřák skutečně čte: čerstvý vstup za 1x, zápisy do cache za 1,25x (5minutová cache) nebo 2x (1hodinová cache), čtení z cache za 0,1x. A každé srovnání je normalizováno podle vykonané práce, buď podle promptů, které jsem napsal, nebo podle volání API, která agent provedl.
Přihlaste se k odběru newsletteru
Získejte nejnovější tipy, trendy a nabídky zdarma.
Dvě relace, stejný agent
Tohle je mechanismus na jednom obrázku. Vlevo skutečná relace z 3. září, před stropem. Vpravo skutečná relace z 15. září, po něm.
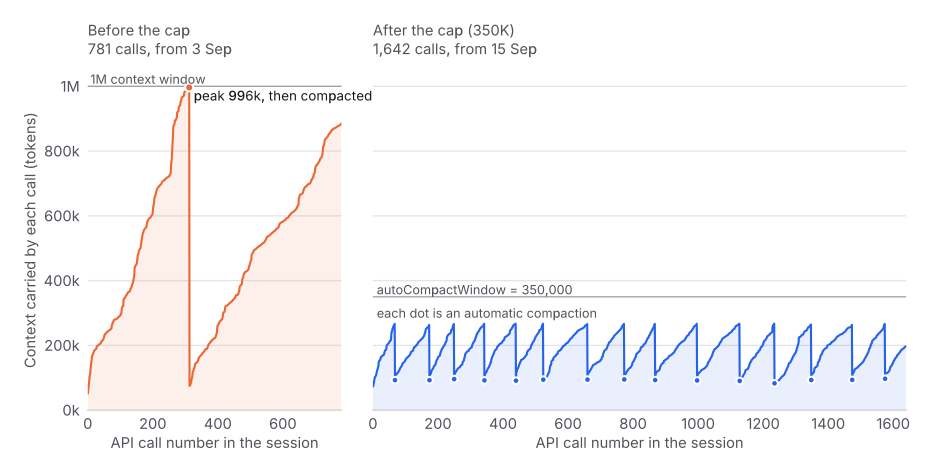
Relace vlevo běžela 781 volání. Vystoupala na 996 000 tokenů kontextu, narazila na zeď 1M okna, jednou se zhutnila a pak vystoupala rovnou zpět na 880 000. V druhé polovině této relace každé jednotlivé volání znovu četlo více než půl milionu tokenů.
Relace vpravo běžela 1 642 volání, více než dvakrát tak dlouho, a nikdy nenesla více než 270 000. Zhutnila se patnáctkrát. Každé zhutnění je tečka.
Týdenní čísla
Jen interaktivní relace. Sloupce jsou vstupní tokeny vážené cache na volání API, což je nejférovější jediné číslo, protože ho nezajímá, jak moc jsem v daném týdnu pracoval.
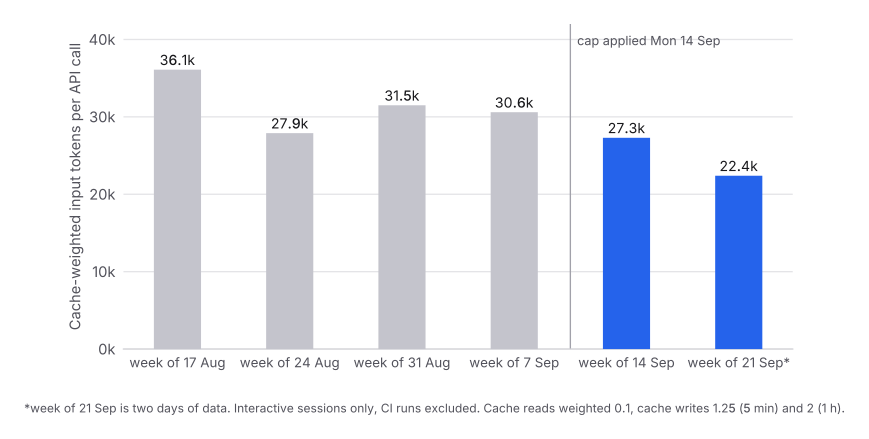
Nejčistší srovnání v datovém souboru je týden 7. září proti týdnu 14. září, protože jsem si je nevybral. Prostě padly na obě strany změny a v každém jsem napsal téměř přesně stejný počet promptů.
| Týden od | Prompty | Volání API | Vstup vážený cache | Na volání |
|---|---|---|---|---|
| 7. září | 971 | 11 364 | 348,1M | 30,6k |
| 14. září | 968 | 10 555 | 288,5M | 27,3k |
971 promptů proti 968. Efektivní vstup klesl z 348,1M na 288,5M. To je o 17 % méně za stejné množství promptování. Dva dny následujícího týdne vyšly na 22,4k na volání, ještě níž.
Kam peníze odcházely
Rozdělte každé volání API podle toho, kolik kontextu neslo, a mechanismus je vidět přímo.
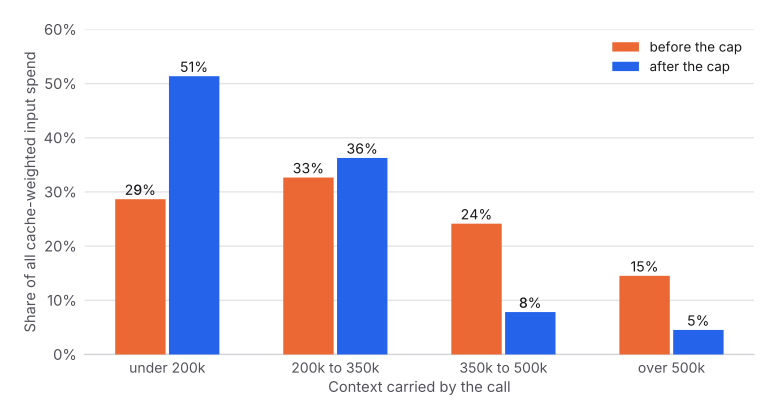
Před stropem šlo 39 % všeho, co jsem utratil, na volání, která za sebou táhla více než 350 000 tokenů historie. Ta volání nedělala víc práce než ostatní. Byla to stejná práce s větší bagáží. Po stropu je tento podíl 12 %.
Vydržel strop?
Jedna tečka na relaci, umístěná u největšího kontextu, který relace kdy nesla.
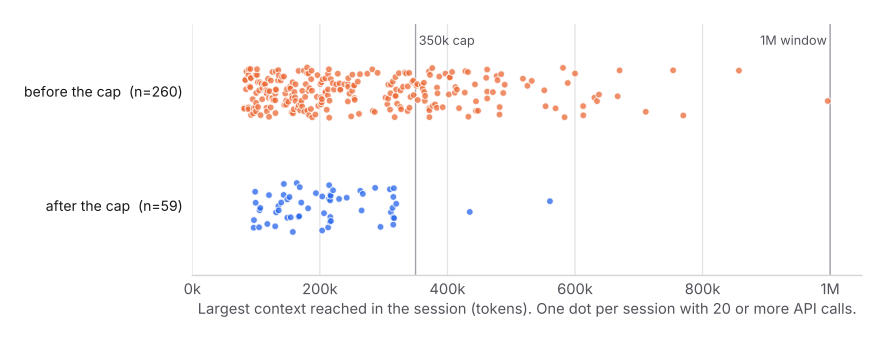
Dvě relace v prvních dvou dnech stále běžely přes strop, na 434 000 a 561 000, a nezjistil jsem proč. Od zavedení nastavení 350 000 dne 18. září žádná relace tuto hodnotu nepřekročila. Ocas relací žijících mezi 500k a 1M, kde bylo nejvíc plýtvání, je pryč.
Kolik by to stálo bez stropu
Abych to shrnul do celkové částky, přehrál jsem každou relaci, která začala po změně, jako by vypuštěný kontext nebyl nikdy shrnut a byl stále znovu čten při každém dalším volání, ohraničený na 1M okno.
| Vstup vážený cache | |
|---|---|
| Skutečnost, 73 relací, 9 675 volání, 55 zhutnění | 216,8M |
| Stejné relace bez stropu | 479,2M |
| Ušetřeno | 262,5M, tedy 55 % |
Relace vpravo na prvním grafu tvoří 118,5M z toho sama. Dlouhý refaktoring, který by jinak strávil svých posledních několik stovek volání opětovným čtením téměř milionu tokenů při každém z nich.
Berte 55 % jako optimistický konec. Bez stropu bych opravdu nenechal relaci hodiny mlít na 900k; nakonec bych ji vymazal ručně, což náklady také resetuje. Konzervativní konec je pozorované číslo na volání, z 30,6k na 22,4k, tedy zhruba 20 % až 27 %. Pravda je někde mezi tím.
Co vás to stojí
Není to zdarma a každý, kdo to doporučuje, by to měl říct.
Čekání. 67 zhutnění od změny, v mediánu asi tři minuty každé. Zhruba 3,4 hodiny sledování, jak se píše shrnutí, rozložených do osmi dnů.
Nějaké přepracování. Zhutnění toho dost vypustí. Při nastavení 350K vzalo mediánové zhutnění relaci s 318 000 tokeny dolů na 24 000. Agent ztrácí detail a někdy ho znovu staví: soubory znovu přečtené v téže relaci vzrostly z 11,5 % čtení před prvním zhutněním na 20,5 % po něm. Vzorek za tím druhým číslem je malý, takže ho čtěte jako směr, ne jako měření.
Volba prahu je důležitá. Při 250K dosáhlo zhutnění 36 % mých dlouhých relací. Při 350K to bylo 12 %, a strop přitom stále držel. Nastavte ho příliš nízko a zaplatíte ty tři minuty a přepracování opakovaně za úsporu, kterou jste už měli v kapse.
Jak to nastavit
Claude Code. Přidejte autoCompactWindow do ~/.claude/settings.json. Na modelu s 1M kontextem byla 350 000 nejlepší ze tří hodnot, které jsem vyzkoušel. Na modelu s 200K se posuňte dolů a začněte kolem 120 000 až 140 000. Nové relace to převezmou; už běžící relace si ponechá starou hodnotu.
Jiní agenti. Hledejte stejnou myšlenku pod jiným názvem: spouštěč zhutnění, limit kontextu, práh shrnutí-a-pokračování. Pokud žádný není, ruční verze znamená vymazávat relaci častěji, než se zdá přirozené. Instinkt udržovat jednu dlouhou relaci živou celý den, protože „zná projekt", je ten drahý.
Ať používáte cokoli, dva návyky udělají víc než jakékoli nastavení. Udržujte trvalý stav v souborech, ne v konverzaci, aby agent mohl levně znovu přečíst jeden soubor místo toho, aby navždy nesl každou předchozí odpověď. A práci náročnou na čtení přenechejte subagentům s vlastním krátkodobým kontextem, aby těch dvacet souborů, které přečtou, vůbec nevstoupilo do hlavní relace.
Pokud jste na týdenním limitu
Pokud platíte předplatné s týdenním limitem využití místo účtu za token, je to páka s nejlepším poměrem úsilí k efektu, jakou jsem našel. Jeden řádek JSON, žádná změna toho, jak pracujete, a stejný limit se měřitelně protáhne. V mém případě stejný týdenní objem promptování stál o 17 % méně a dlouhé relace asi polovinu.
Čtěte dál
Kontextová okna se prodávají jako kapacita. Chovají se jako běžící měřák, účtovaný při každém tahu za všechno, co jste kdy vložili. Pokud chcete mechanismus za tímhle místo pouhého nastavení, doprovodný článek prochází, co kontextové okno skutečně zaplňuje, proč dlouhá relace stojí mnohem víc než práce, kterou vykoná, a jak cache, mazání a zhutnění mění aritmetiku.
